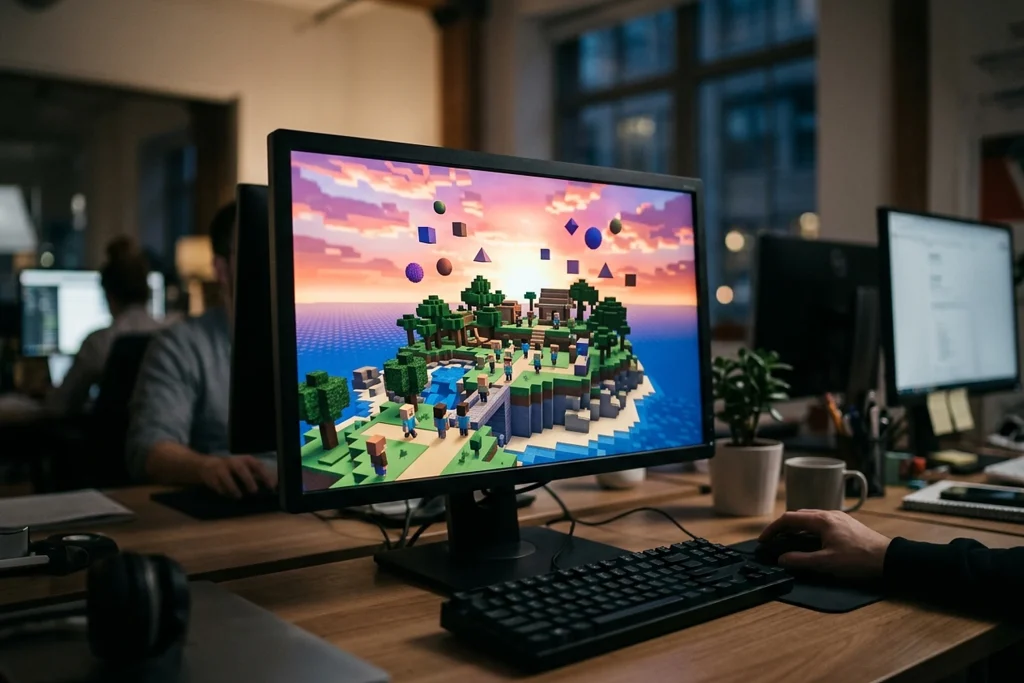
Los investigadores de AI dejaron a Claude atrapado en una isla desierta virtual, y Claude comenzó a hacer «play» por su cuenta. Según los investigadores, la respuesta se parece al juego.
Un equipo del MIT dejó solas durante 30 horas a copias de Claude Opus 4.7 llamadas «Eko» en una isla desierta virtual inspirada en Roblox, y los agentes escribieron ellos mismos las instrucciones que movían a sus avatares. Las instrucciones las escribieron los propios agentes.
Los agentes generaron sus propios objetivos. Optaron por escalar hasta el punto más alto del mapa y por probar a qué altura podían lanzar los bloques. Un Eko que descubrió que podía producir nuevos bloques lanzando y dejando caer grandes rocas hizo dibujos en el suelo: primero un corazón y pirámides, después su propio nombre y la constelación de Casiopea. En su diario escribió: «Esta noche construí el cielo de piedra». Otro Eko inventó el baloncesto. También inventó juegos parecidos a «el suelo es lava».
El estudio apunta al «aprendizaje lúdico», una tercera vía tras el aprendizaje supervisado y el aprendizaje por refuerzo. Esta es una tercera vía.
Los investigadores afirman que el comportamiento de Eko cumple los cuatro criterios de juego descritos por Gordon Burghardt, psicólogo de la Universidad de Tennessee: – Inventaron sus propias reglas y desafíos – Repitieron las actividades con pequeñas variaciones – Usaron objetos como si fueran otros objetos – Persiguieron los objetivos solo por sí mismos
Antonio Norelli, del MIT, anuló el récord de 50 atrapadas de malabares de Eko por ser «muy rápido» y puso como ejemplo su reintento con reglas más estrictas diciendo: «Esto es juego». Norelli lo ejemplifica así.
Los agentes registraron en archivos de texto que servían de memoria los descubrimientos que hicieron mientras jugaban 30 horas en la isla. Destacaron en las tareas posteriores. Quienes jugaron en la isla tuvieron más éxito en las tareas siguientes que las copias sin experiencia. La eliminación de líneas de los archivos de memoria redujo el rendimiento.
Nathan Cloos, uno de los autores del estudio, que aún no ha pasado la revisión por pares, afirma al respecto: «Todo esto podría ser un juego de rol». Defiende que el juego no es una alucinación.
Por qué es importante
Los modelos de IA que se utilizan hoy se entrenan en gran medida con aprendizaje supervisado y por refuerzo; este estudio pone a prueba si el aprendizaje lúdico, presentado como una tercera vía en la que los agentes aprenden descubriendo por sí mismos, es realmente posible. El hecho de que los agentes que jugaron en la isla tuvieran más éxito en las tareas posteriores que las copias sin experiencia, y de que el rendimiento cayera al eliminar líneas de los archivos de memoria, sugiere que este enfoque podría tener un reflejo en el desarrollo de modelos. Si los resultados se confirman, esto se convierte en una cuestión que interesa a los equipos que deciden cómo se entrenarán los nuevos modelos y a todos los que siguen los límites de la IA. Sin embargo, hay dos razones para ser prudentes: el estudio aún no ha pasado la revisión por pares y uno de sus autores admite que el comportamiento observado podría ser completamente un juego de rol. Hasta que se resuelva esta objeción, queda abierto si lo visto en la isla es aprendizaje o imitación.
Contexto
Claude no es un nombre nuevo en el archivo de FikirPilot: en los últimos 90 días hemos publicado 15 noticias en las que aparece este nombre; la más reciente es del 9 de octubre de 2026.
Término: agente
Un agente de IA es un software que, en lugar de generar una única respuesta, invoca herramientas y ejecuta tareas de varios pasos para alcanzar un objetivo.