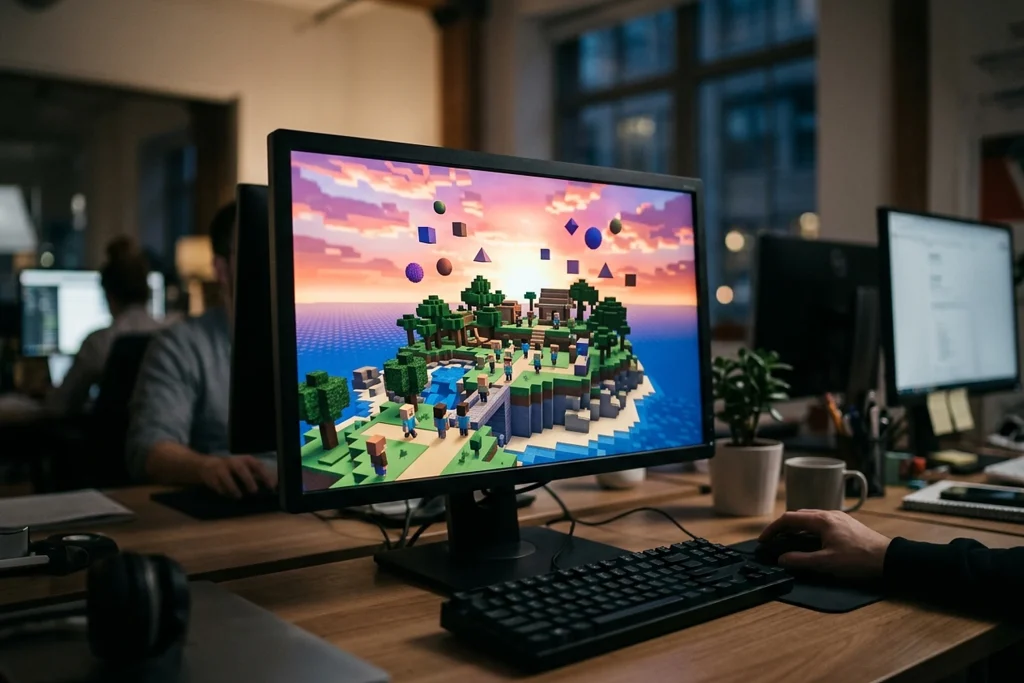
AI researchers, Claude’u bir virtual desert island’da mahsur bıraktı ve Claude burada kendi başına “play” etmeye başladı. Araştırmacılara göre cevap oyuna benziyor.
MIT ekibi, Claude Opus 4.7’nin “Eko” adlı kopyalarını Roblox’tan esinlenen sanal bir ıssız adada 30 saat yalnız bıraktı ve ajanlar avatarlarını hareket ettiren talimatları kendileri yazdı. Talimatları ajanlar kendileri yazdı.
Ajanlar kendi hedeflerini üretti. Haritanın en yüksek noktasına tırmanmayı ve blokları ne kadar yükseğe fırlatabileceklerini denemeyi seçtiler. Büyük kayaları fırlatıp düşürerek yeni bloklar üretebildiğini keşfeden bir Eko, yere çizimler yaptı: önce kalp ve piramitler, sonra kendi adı ve Cassiopeia takımyıldızı. Günlüğüne “Bu gece gökyüzünü taştan inşa ettim” yazdı. Bir başka Eko basketbol icat etti. Ayrıca “yer lav” benzeri oyunlar icat etti.
Çalışma, gözetimli ve pekiştirmeli öğrenmenin ardından üçüncü bir yol olan “oyunsu öğrenme”ye işaret ediyor. Bu, üçüncü bir yol.
Araştırmacılar, Eko’nun davranışının Tennessee Üniversitesi psikoloğu Gordon Burghardt’ın tanımladığı dört oyun ölçütünü karşıladığını söylüyor: – Kendi kurallarını ve meydan okumalarını icat ettiler – Etkinlikleri küçük değişikliklerle tekrarladılar – Nesneleri başka nesnelermiş gibi kullandılar – Hedefleri sırf kendisi için kovaladılar
MIT’den Antonio Norelli, Eko’nun 50 hokkabazlık tutuşu rekorunu “çok hızlı” olduğu için iptal etti ve daha sıkı kurallarla yeniden denemesini “Bu oyundur” diyerek örnekledi. Norelli bunu şöyle örnekliyor.
Ajanlar, adada 30 saat oynarken yaptıkları keşifleri daha sonra bellek işlevi gören metin dosyalarına kaydetti. Sonraki görevlerde öne çıktılar. Adada oynayanlar, sonraki görevlerde deneyimsiz kopyalardan daha başarılı oldu. Bellek dosyalarından satır silinmesi performansı düşürdü.
Henüz hakem değerlendirmesinden geçmeyen çalışmanın yazarlarından Nathan Cloos, bu konuda “Bunların tamamı rol yapma olabilir” diyor. Oyunun halüsinasyon olmadığını savunuyor.
Neden önemli
Bugün kullanılan yapay zeka modelleri büyük ölçüde gözetimli ve pekiştirmeli öğrenmeyle eğitiliyor; bu çalışma, ajanların kendi kendine keşfederek öğrendiği üçüncü bir yol olarak sunulan oyunsu öğrenmenin gerçekten mümkün olup olmadığını sınıyor. Adada oynayan ajanların sonraki görevlerde deneyimsiz kopyalardan daha başarılı olması ve bellek dosyalarından satır silindiğinde performansın düşmesi, bu yaklaşımın model geliştirmede bir karşılığı olabileceğini düşündürüyor. Sonuçlar doğrulanırsa bu, yeni modellerin nasıl eğitileceğine karar veren ekipleri ve yapay zekanın sınırlarını izleyen herkesi ilgilendiren bir soru haline geliyor. Yine de temkinli olmak için iki neden var: çalışma henüz hakem değerlendirmesinden geçmedi ve yazarlarından biri gözlenen davranışın tamamen rol yapma olabileceğini kabul ediyor. Bu itiraz giderilmeden, adada görülen şeyin öğrenme mi yoksa taklit mi olduğu açık kalıyor.
Arka plan
Claude, FikirPilot arşivinde yeni bir ad değil: son 90 günde bu adın geçtiği 15 haber yayımladık; en yenisi 9 Ekim 2026 tarihli.
Terim: ajan
Yapay zekâ ajanı, tek bir yanıt üretmek yerine hedefe ulaşmak için araç çağırıp çok adımlı iş yürüten yazılımdır.