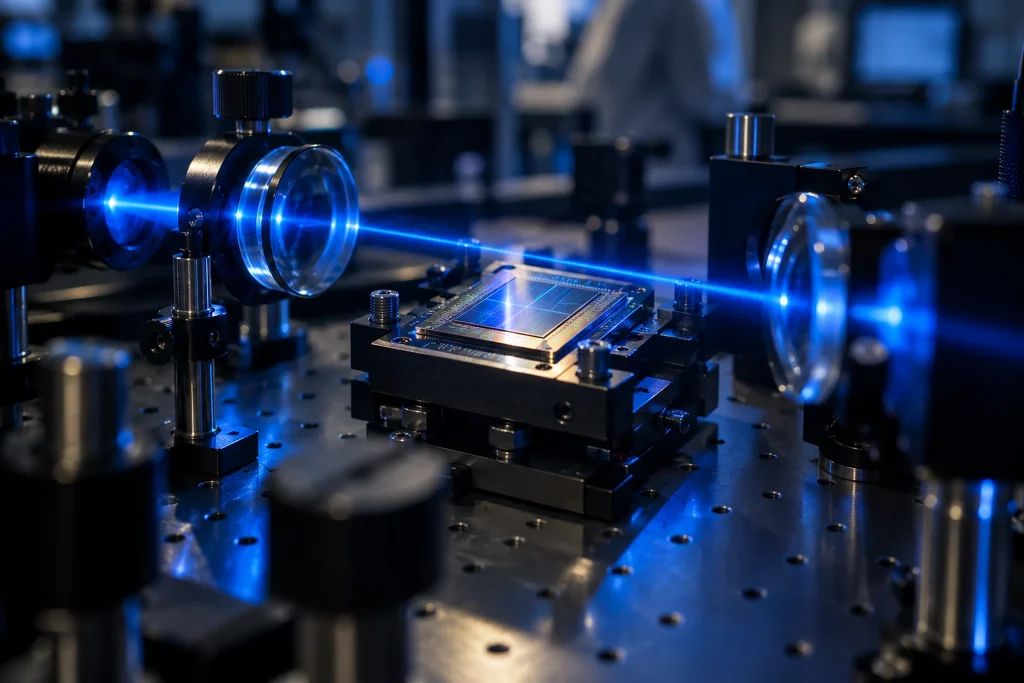
Les chercheurs de UCLA ont développé un nouveau processeur optique-neuronal qui utilise la lumière pour identifier rapidement et précisément les vidéos deepfake. Alors que les systèmes numériques traditionnels examinent généralement les vidéos l’une après l’autre, cette technologie peut analyser simultanément 15 flux vidéo ou plus en un seul passage optique. L’étude a été publiée dans eLight sous le titre « Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection ».
Dans le système, un encodeur numérique léger transforme les caractéristiques spatiales, spectrales et temporelles des vidéos en informations compactes. Ces informations sont converties en motif de phase dans un modulateur spatial de lumière programmable. Le front d’onde optique traverse ensuite un décodeur optique passif basé sur l’espace libre, et des détecteurs optiques appariés produisent directement un score de véracité pour chaque vidéo. Ainsi, une partie du décodage, qui nécessite habituellement d’importants calculs numériques, est réalisée par diffraction de la lumière.
Lors d’expériences menées avec de la lumière visible, le processeur a examiné simultanément 15 vidéos Celeb-DF à chaque passage optique. La précision moyenne s’est établie à 97,79 %, la sensibilité à 99,86 % et la spécificité à 95,72 %. Le taux de faux négatifs correspondant au résultat de sensibilité a été calculé à environ 0,14 %. Lorsque la capacité a été portée à 18 vidéos, la précision est restée à 96,13 %. Dans le cas de manipulations deepfake plus difficiles, l’ajout de deux couches diffractives optimisées au décodeur optique passif a augmenté la précision d’environ 6,8 %. Ces structures passives effectuent des calculs optiques sans nécessiter de puissance électrique supplémentaire.
Les chercheurs ont également testé le système sur des vidéos générées par le modèle VEO-3 de Google, ainsi que sur des vidéos jamais vues auparavant. Avec un réglage fin limité, la précision s’est établie à 94,80 % et la sensibilité à 97,61 %. Le processeur a en outre résisté aux attaques adversariales en boîte noire et assuré une protection matérielle contre les attaques en boîte blanche. Il a également continué à fonctionner en présence de bruit d’image, de flou, de compression JPEG et d’erreurs expérimentales d’alignement.
L’équipe de UCLA a conçu le système non pas comme un outil destiné à remplacer les détecteurs numériques avancés, mais comme une première couche de défense capable d’analyser des vidéos en grand volume. Les contenus suspects pourront être transmis à des modèles numériques plus détaillés. Il a été indiqué que cette approche pourrait être utilisée dans les applications d’intelligence artificielle axées sur la modération des contenus, la vérification des médias, la surveillance et la sécurité. Parnian Ghapandar Kashani, le Dr Shiqi Chen et le professeur Aydogan Ozcan ont contribué à l’étude.
Contexte
Nearly n’est pas un nom nouveau dans les archives de FikirPilot : nous avons publié 4 articles mentionnant ce nom au cours des 90 derniers jours ; le plus récent date du 29 septembre 2026.