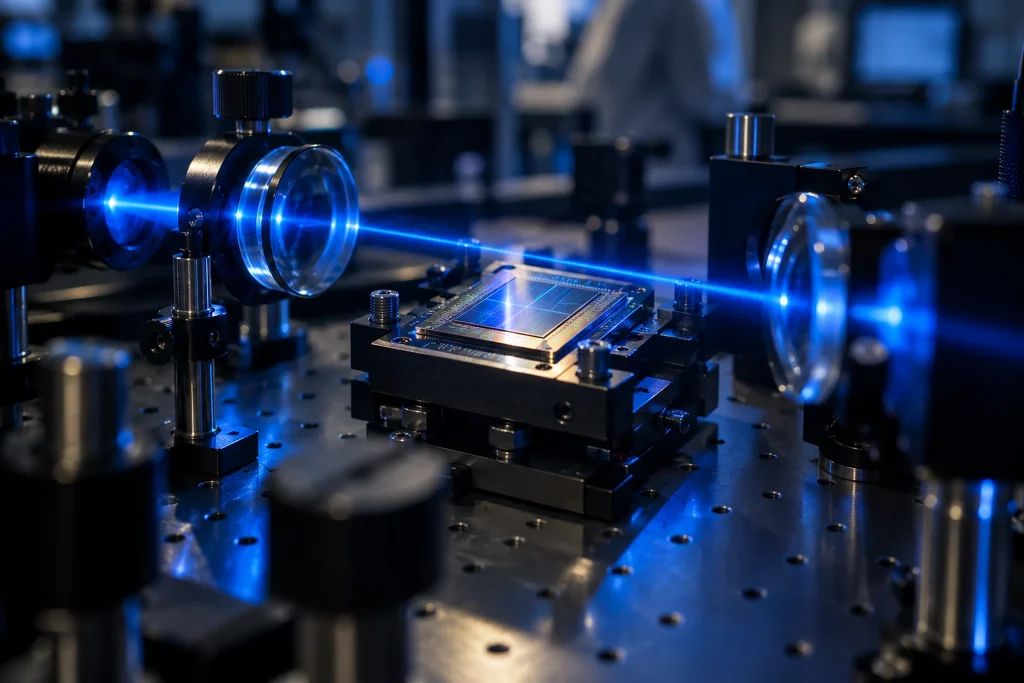
UCLA-Forschende haben einen neuen optisch-neuronalen Prozessor entwickelt, der Licht nutzt, um Deepfake-Videos schnell und präzise zu erkennen. Während herkömmliche digitale Systeme Videos in der Regel nacheinander untersuchen, kann diese Technologie 15 oder mehr Videostreams in einem einzigen optischen Durchgang gleichzeitig analysieren. Die Studie wurde unter dem Titel „Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection“ in eLight veröffentlicht.
In dem System wandelt ein leichter digitaler Encoder die räumlichen, spektralen und zeitlichen Merkmale der Videos in kompakte Informationen um. Diese Informationen werden in einem programmierbaren räumlichen Lichtmodulator in ein Phasenmuster umgewandelt. Anschließend durchläuft die optische Wellenfront einen passiven optischen Decoder auf Basis des freien Raums, und gepaarte optische Detektoren erzeugen für jedes Video direkt einen Echtheitsscore. Auf diese Weise wird ein Teil des Decodierungsvorgangs, der intensive digitale Berechnungen erfordert, durch die Beugung des Lichts ausgeführt.
In Experimenten mit sichtbarem Licht untersuchte der Prozessor bei jedem optischen Durchgang gleichzeitig 15 Celeb-DF-Videos. Die durchschnittliche Genauigkeit lag bei 97,79 %, die Sensitivität bei 99,86 % und die Spezifität bei 95,72 %. Aus dem Sensitivitätsergebnis wurde eine Falsch-Negativ-Rate von etwa 0,14 % berechnet. Als die Kapazität auf 18 Videos erhöht wurde, blieb die Genauigkeit bei 96,13 %. Bei schwierigeren Deepfake-Manipulationen erhöhte das Hinzufügen von zwei optimierten diffraktiven Schichten zum passiven optischen Decoder die Genauigkeit um etwa 6,8 %. Diese passiven Strukturen führen optische Berechnungen durch, ohne zusätzliche elektrische Leistung zu benötigen.
Die Forschenden testeten das System auch mit zuvor nicht gesehenen Videos, die mit Googles Modell VEO-3 erzeugt wurden. Bei begrenztem Fine-Tuning lagen die Genauigkeit bei 94,80 % und die Sensitivität bei 97,61 %. Der Prozessor erwies sich zudem als resistent gegen Black-Box-Gegnerangriffe und bot Hardwareschutz gegen White-Box-Angriffe. Auch bei Bildrauschen, Unschärfe, JPEG-Komprimierung und experimentellen Ausrichtungsfehlern arbeitete er weiterhin.
Das UCLA-Team konzipierte das System weniger als Ersatz für fortschrittliche digitale Detektoren, sondern als erste Verteidigungsebene, die Videos in großen Mengen scannt. Verdächtige Inhalte können an detailliertere digitale Modelle weitergeleitet werden. Es wurde erklärt, dass der Ansatz in Anwendungen der künstlichen Intelligenz für die Inhaltsmoderation, Medienverifizierung, Überwachung und Sicherheit eingesetzt werden könnte. Zu der Studie trugen Parnian Ghapandar Kashani, Dr. Shiqi Chen und Professor Aydogan Ozcan bei.
Hintergrund
Nearly ist im FikirPilot-Archiv kein neuer Name: In den vergangenen 90 Tagen haben wir 4 Nachrichten veröffentlicht, in denen dieser Name erwähnt wurde; die jüngste stammt vom 29. September 2026.