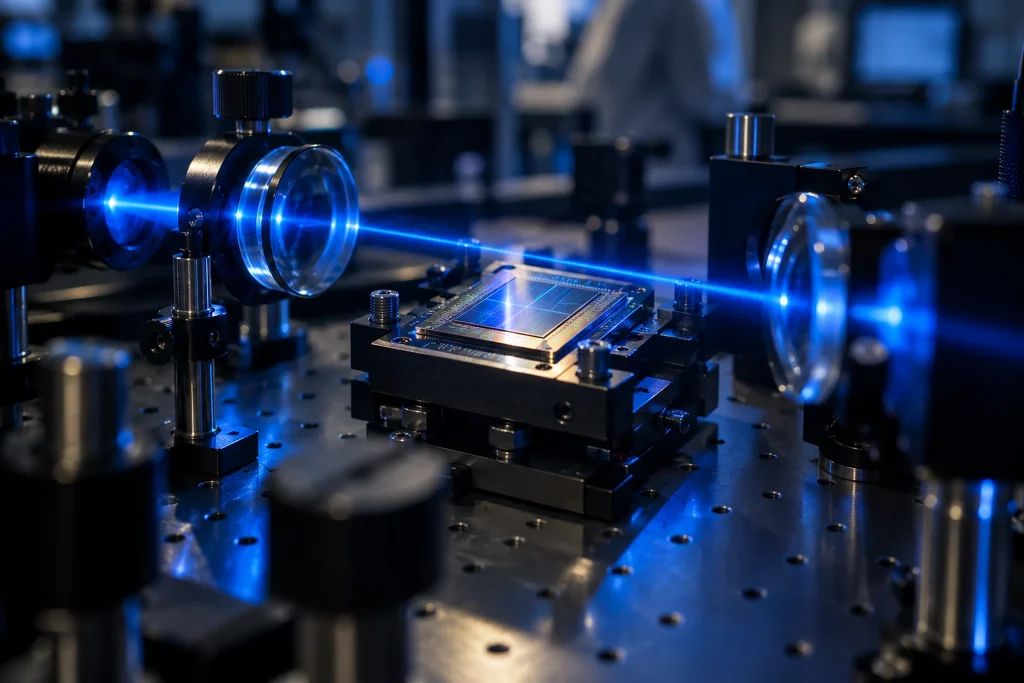
UCLAの研究者らは、ディープフェイク動画を迅速かつ正確に識別するため、光を利用する新たな光ニューラルプロセッサーを開発した。従来のデジタルシステムが通常、動画を順番に調べるのに対し、この技術は1回の光通過で15以上の動画ストリームを同時に分析できる。研究成果は「Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection」と題され、eLightに掲載された。
このシステムでは、軽量なデジタルエンコーダーが動画の空間的、スペクトル的、時間的特徴をコンパクトな情報に変換する。この情報は、プログラム可能な空間光変調器で位相パターンに変換される。続いて光波面が自由空間ベースのパッシブ光デコーダーを通過し、対応する光検出器が各動画について真正性スコアを直接生成する。これにより、集中的なデジタル計算を必要とするデコード処理の一部が、光の回折によって実行される。
可視光を用いた実験では、プロセッサーは1回の光通過ごとに15本のCeleb-DF動画を同時に調べた。平均精度は97.79%、感度は99.86%、特異度は95.72%となった。感度の結果に対応する偽陰性率は約0.14%と算出された。容量を18本の動画に拡大した場合も、精度は96.13%の水準を維持した。より困難なディープフェイク操作では、パッシブ光デコーダーに2層の最適化された回折層を追加することで、精度が約6.8%向上した。これらのパッシブ構造は、追加の電力を必要とせずに光学計算を行う。
研究者らは、GoogleのVEO-3モデルによって生成された、これまで見たことのない動画でもシステムを試験した。限定的なファインチューニングにより、精度は94.80%、感度は97.61%となった。プロセッサーはブラックボックス型の敵対的攻撃にも耐性を示し、ホワイトボックス型攻撃に対してはハードウェア上の保護を提供した。画像ノイズ、ぼかし、JPEG圧縮、実験的なアライメント誤差がある場合でも動作を続けた。
UCLAのチームは、このシステムを高度なデジタル検出器に取って代わるツールというよりも、大量の動画をスキャンする第1の防御層として設計した。疑わしいコンテンツは、より詳細なデジタルモデルに引き渡すことができる。このアプローチは、コンテンツモデレーション、メディア認証、監視、セキュリティを重視した人工知能アプリケーションで利用できるとされた。研究には、Parnian Ghapandar Kashani、Dr. Shiqi Chen、Aydogan Ozcan教授が貢献した。
背景
Nearlyは、FikirPilotのアーカイブで新しい名前ではない。直近90日間に、この名前が登場する4本の記事を公開しており、最も新しい記事は2026年9月29日付だ。