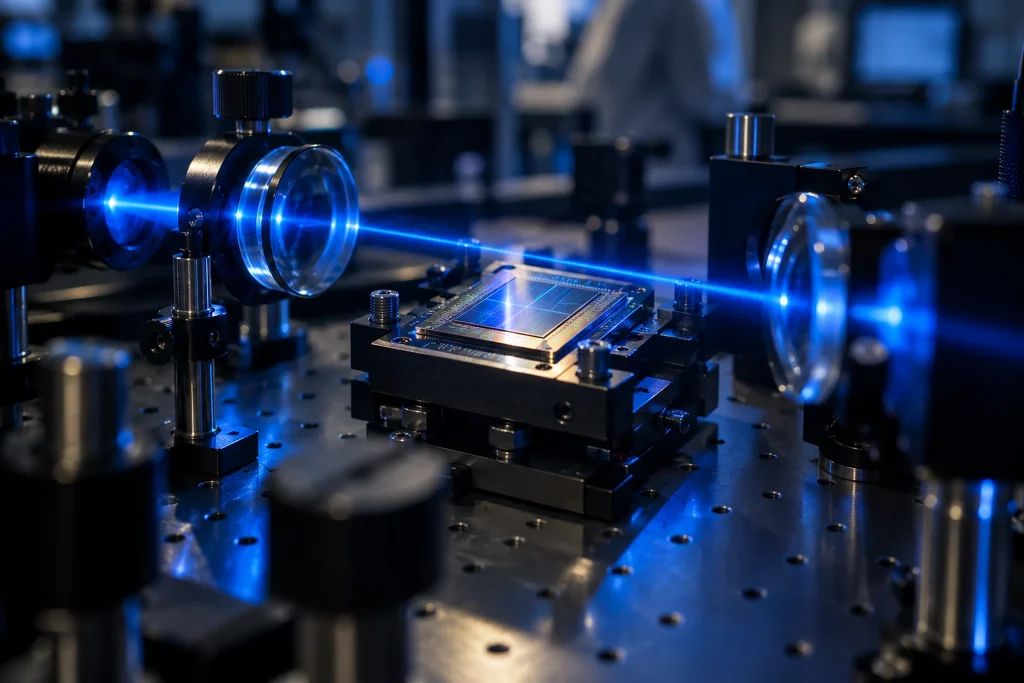
Исследователи UCLA разработали новый оптико-нейронный процессор, использующий свет для быстрого и точного выявления deepfake-видео. В то время как традиционные цифровые системы обычно анализируют видео последовательно, эта технология способна одновременно анализировать 15 или более видеопотоков за один оптический проход. Исследование опубликовано в eLight под названием «Scalable, Energy-Efficient Optical-Neural Architecture for Multiplexed Deepfake Video Detection».
В системе легкий цифровой кодировщик преобразует пространственные, спектральные и временные характеристики видео в компактную информацию. Эта информация преобразуется в фазовый рисунок в программируемом пространственном модуляторе света. Затем оптический волновой фронт проходит через пассивный оптический декодер на основе свободного пространства, а согласованные оптические детекторы напрямую формируют оценку подлинности для каждого видео. Таким образом, часть декодирования, требующего интенсивных цифровых вычислений, выполняется за счет дифракции света.
В экспериментах с видимым светом процессор одновременно анализировал 15 видео Celeb-DF за каждый оптический проход. Средняя точность составила 97,79%, чувствительность — 99,86%, а специфичность — 95,72%. В соответствии с результатом по чувствительности уровень ложноотрицательных результатов составил примерно 0,14%. При увеличении емкости до 18 видео точность сохранилась на уровне 96,13%. При более сложных deepfake-манипуляциях добавление двух оптимизированных дифракционных слоев к пассивному оптическому декодеру повысило точность примерно на 6,8%. Эти пассивные структуры выполняют оптические вычисления без дополнительного потребления электроэнергии.
Исследователи также протестировали систему на ранее не виденных видео, созданных моделью Google VEO-3. При ограниченной тонкой настройке точность составила 94,80%, а чувствительность — 97,61%. Процессор также продемонстрировал устойчивость к атакам типа black-box и обеспечил аппаратную защиту от атак типа white-box. Система продолжала работать и при наличии шумов изображения, размытия, JPEG-сжатия и экспериментальных ошибок выравнивания.
Команда UCLA разработала систему не столько как замену продвинутым цифровым детекторам, сколько как первый уровень защиты для сканирования больших объемов видео. Подозрительный контент можно будет передавать более детализированным цифровым моделям. Было отмечено, что этот подход может применяться в модерации контента, верификации медиаматериалов, системах наблюдения и приложениях искусственного интеллекта, ориентированных на безопасность. Вклад в исследование внесли Parnian Ghapandar Kashani, Dr. Shiqi Chen и Professor Aydogan Ozcan.
Предыстория
Nearly — не новое имя в архиве FikirPilot: за последние 90 дней мы опубликовали 4 новости с упоминанием этого названия; самая свежая датирована 29 сентября 2026 года.